Segmentation, détection, classification, OCR, détection d'anomalie et super-résolution par des modèles au format ONNX. Pour chaque type : ONC… charge le modèle n° J (fichier .onnx ou export Geti .zip, dont le chemin est dans la chaîne globale K ; un nom seul est cherché dans Config\Onnx\<type>\, ./… dans le dossier du programme ; L = 0 automatique, 1 processeur, 2 carte graphique), ONX… l'exécute sur la zone D,E - G,H, ONR… lit un résultat (M = type de résultat). Coordonnées rendues en repère pièce. ONXOCV vérifie un texte attendu (trame d'un lot, date…) avec des gabarits appris sur la vraie impression : une vingtaine de ms par ligne au lieu d'une lecture complète.
Charge un modèle de segmentation (n° J, fichier dans la chaîne K, mode L).
Paramètres
- J
- Index ONNX (0..30)
- K
- Chemin .onnx
- L
- Mode (0 auto / 1 CPU / 2 GPU)
- P = 1 ou code d'erreur négatif ; Q = nombre de labels.
Segmentation de la zone par le modèle J ; carte de chaleur dans le plan L, seuil de confiance M (0,30 par défaut), filtre de label N, plan de comparaison K ; F = chaîne du projet Geti (envoi d'images).
Paramètres
- D
- X1 (ROI)
- E
- Y1 (ROI)
- F
- Projet Geti (0=?)
- G
- X2 (ROI)
- H
- Y2 (ROI)
- J
- Index ONNX (0..30)
- K
- Plan Repli comparaison (0=aucun)
- L
- Plan Heatmap (sortie)
- M
- Seuil confiance (0..1, défaut 0.30 si vide)
- N
- Filtre label heatmap (0=tous, index>0=un seul)
Résultats
- P
- 1=Ok, negatif=erreur
- Q
- Total
- R
- Filtre N
- S
- Label/N
- T
- X1 (HG)
- U
- Y1 (HG)
- V
- Surface
- W
- X2 (BD)
- X
- Y2 (BD)
- Y
- Score
Résultat de la segmentation : M = 1 nom de label (chaîne L), 2 id, 3 boîte du n-ième objet (L) d'un label K.
Paramètres
- J
- Index ONNX (0..30)
- K
- Index label (1/2/3) - pour 3 : <=0=toutes classes, >0=index
- L
- Selon M (1=n ChaineGlobale ; 3=n-ième objet trouve, 1-based)
- M
- Type résultat (1=Nom label, 2=Id label, 3=Bounding box)
Résultats
- P
- 1=Ok, negatif=erreur
- S
- N° objet (M=3)
- T
- X1 (HG)
- U
- Y1 (HG)
- V
- Surface
- W
- X2 (BD)
- X
- Y2 (BD)
- Y
- Score
Charge un modèle de détection (n° J, fichier dans la chaîne K, mode L, prétraitement M 0 auto / 1 Ultralytics / 2 Geti, chaîne N = famille reconnue).
Paramètres
- J
- Index modèle (1..32)
- K
- Chemin .onnx ou .zip
- L
- Mode (0 auto / 1 CPU / 2 GPU)
- M
- Pre-traitement (0 auto / 1 Ultralytics / 2 Geti)
- N
- Famille modèle (0=non)
- P = 1 ou code d'erreur ; Q labels, R,S taille d'entrée, T code de famille du modèle, U,V seuils de confiance et d'IoU recommandés par le modèle.
Détection d'objets dans la zone par le modèle J : M confiance, N filtre de label, O IoU de la NMS (0 = valeurs du modèle).
Paramètres
- D
- X1 (ROI)
- E
- Y1 (ROI)
- F
- Projet Geti (0=?)
- G
- X2 (ROI)
- H
- Y2 (ROI)
- J
- Index modèle (1..32)
- M
- Confiance (0 = seuil du modèle, sinon 0..1)
- N
- Filtre label (<=0 = tous, >0 = INDEX du label)
- O
- IoU NMS (0 = seuil du modèle, sinon 0..1)
Résultats
- P
- 1=Ok, negatif=erreur
- Q
- Total
- R
- Filtre N
- S
- Label/N
- T
- X1 (HG)
- U
- Y1 (HG)
- V
- Surface
- W
- X2 (BD)
- X
- Y2 (BD)
- Y
- Score
Résultat de la détection : M = 1 nom de label, 2 id réel, 3 boîte du n-ième objet.
Paramètres
- J
- Index modèle (1..32)
- K
- Index du label (type 3 : <=0 = toutes classes)
- L
- Type 1 = chaîne globale dest. / type 3 = n-ième objet
- M
- Type (1=nom label, 2=ID réel, 3=bounding box)
Résultats
- P
- 1=Ok, negatif=erreur
- S
- N-ième
- T
- X1 (HG)
- U
- Y1 (HG)
- V
- Surface
- W
- X2 (BD)
- X
- Y2 (BD)
- Y
- Score
Charge un modèle de classification (mêmes paramètres que ONCDET).
Paramètres
- J
- Index modèle (1..32)
- K
- Chemin .onnx ou .zip
- L
- Mode (0 auto / 1 CPU / 2 GPU)
- M
- Pre-traitement (0 auto / 1 Ultralytics / 2 Geti)
- N
- Famille modèle (0=non)
- P = 1 ou erreur ; Q labels, R,S taille d'entrée, T famille, U seuil recommandé.
Classification de la zone par le modèle J : chaîne K = classe gagnante, M = 0 auto / 1 multilabel / 2 une gagnante, N = seuil de décision.
Paramètres
- D
- X1 (ROI)
- E
- Y1 (ROI)
- F
- Projet Geti (0=?)
- G
- X2 (ROI)
- H
- Y2 (ROI)
- J
- Index modèle (1..32)
- K
- Nom classe gagnante (0=non)
- M
- 0=auto (modèle), 1=multilabel, 2=une gagnante
- N
- Seuil de decision (0 = celui du modèle, sinon 0..1)
Résultats
- P
- 1=Ok, negatif=erreur
- Q
- Nb classes
- R
- Index 1re
- S
- Score 1re
- T
- Nb >= seuil
- U
- Index 2e
- V
- Score 2e
- W
- Index 3e
- X
- Score 3e
- Y
- Marge
Résultat de la classification : M = 1 nom de label, 2 id, 3 score d'une classe, 4 meilleure classe de rang L.
Paramètres
- J
- Index modèle (1..32)
- K
- Selon M (index label, ou dest. ChaineGlobale si M=4)
- L
- Selon M (dest. ChaineGlobale si M=1, ou rang si M=4)
- M
- Type (1=nom label, 2=ID réel, 3=score classe, 4=meilleure classe)
Résultats
- P
- 1=Ok, negatif=erreur
- S
- Rang L
- Y
- Score
Charge un reconnaisseur OCR (PP-OCR, éventuellement réduit à un jeu de caractères par Onnx\ReduireOcrOnnx.py).
Paramètres
- J
- Numéro du modèle (1 a 32)
- K
- ChaineGlobale du fichier .onnx
- L
- 0 auto / 1 CPU / 2 GPU
- P = 1 ou erreur ; Q = taille du dictionnaire.
Lit le texte de la zone (modèle J, score mini K) dans la chaîne globale L ; M = 1 un objet par caractère, 2 + contours, 3 / 4 = boîtes recalées sur l'encre (pour DRWAOCR / DRWO précis).
Paramètres
- D
- X1 (ROI)
- E
- Y1 (ROI)
- G
- X2 (ROI)
- H
- Y2 (ROI)
- J
- Index modèle (1..32)
- K
- Score minimum (0..1, 0 = pas de filtre)
- L
- ChaineGlobale ou écrire le texte lu
- M
- Objets (1 = un par caractère, 2 = + contours, 3 / 4 = idem recales)
Résultats
- P
- 1=Ok, negatif=erreur
- Q
- Nombre de caractères lus
- R
- Confiance moyenne (0..1)
- T
- X du 1er caractère (repere Piece)
- U
- Y du 1er caractère (repere Piece)
- Le texte lu s'affiche aussi dans la grille.
Résultat OCR : M = 1..5 (texte, n-ième caractère K…).
Paramètres
- J
- Numéro du modèle
- K
- N-ième caractère (M=5, 1-based)
- L
- ChaineGlobale (M=1, 4 ou 5)
- M
- Type de résultat (1 a 5)
Résultats
- P
- 1=Ok, negatif=erreur
Charge un modèle d'anomalie (Anomalib).
Paramètres
- J
- Numéro du modèle (1 a 32)
- K
- ChaineGlobale du fichier
- L
- 0 auto / 1 CPU / 2 GPU
- P = 1 ou erreur ; Q,R = taille d'entrée.
Détection d'anomalie sur la zone : carte d'anomalie dans le plan L (gain M) ; Q = score.
Paramètres
- D
- X1 (ROI)
- E
- Y1 (ROI)
- F
- Projet Anomalib (0=?)
- G
- X2 (ROI)
- H
- Y2 (ROI)
- J
- Index modèle (1..32)
- L
- Plan résultat (carte danomalie)
- M
- Gain sur la carte (0 = x1)
Résultats
- P
- 1=Ok, negatif=erreur
- Q
- Pred_score (0..1)
- R
- Min carte (brut)
- S
- Max carte (brut)
Résultat de l'anomalie (M = 1 à 4).
Paramètres
- J
- Numéro du modèle
- L
- ChaineGlobale (M=4)
- M
- Type de résultat (1 a 4)
Résultats
- P
- 1=Ok, negatif=erreur
Envoi Image vers Anomalib
Envoie l'image de la dernière zone au projet Anomalib de la chaîne F (statut dans la chaîne K).
Paramètres
- F
- Projet Anomalib (OBLIGATOIRE)
- K
- État envoi (0=ne pas écrire)
- P = 1 envoi lancé, −1 sinon.
Envoie la dernière zone mémorisée (par un ONXSEG / ONXDET / ONXCLA) au projet Geti de la chaîne F, en tâche de fond ; statut horodaté dans la chaîne K.
Paramètres
- F
- Projet Geti (OBLIGATOIRE)
- K
- État envoi (0=ne pas écrire)
- P = 1 envoi démarré, −1 sinon (un seul envoi à la fois : une image est ignorée si le précédent n'est pas fini).
Charge un modèle de super-résolution.
Paramètres
- J
- Numéro du modèle (1 a 32)
- K
- ChaineGlobale du fichier .onnx
- L
- 0 auto / 1 CPU / 2 GPU
- P = 1 ou erreur ; Q,R = taille d'entrée.
ONXSUPExecute Super-Resolution
Super-résolution de la zone dans le plan L (M = 0 taille d'origine / 1 zoom).
Paramètres
- D
- X1 (ROI)
- E
- Y1 (ROI)
- G
- X2 (ignore si modèle fixe)
- H
- Y2 (ignore si modèle fixe)
- J
- Index modèle (1..32)
- L
- Plan destination (image complete + résultat)
- M
- 0 = taille origine (filtre) / 1 = zoom
Résultats
- P
- 1=Ok, negatif=erreur
- Q
- Largeur réellement collée
- R
- Hauteur réellement collée
Resultat Super-Resolution
Taille de l'image produite par la dernière super-résolution (Q, R).
Paramètres
- J
- Numéro du modèle (1 a 32)
Résultats
- P
- 1=Ok, negatif=erreur
- Q
- Largeur produite (relue)
- R
- Hauteur produite (relue)
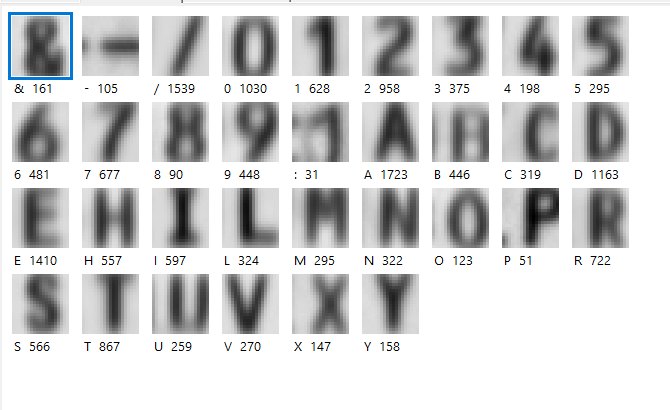
Vérifie, sans le lire, le texte d'une ligne de la zone D,E - G,H contre la trame attendue (chaîne globale K), avec une bibliothèque de gabarits .ocv (chaîne globale N ; nom seul = Onnx\OCV\ du dossier du programme) : une vingtaine de ms par ligne, au lieu de 0,5 à 2 s pour une lecture ONXOCR. Trame : espaces ignorés, # = caractère variable (seule sa présence compte), une suite d'au moins deux X vaut des # (XX/XX/XX). O = 1 = apprentissage : la zone est lue par le modèle ONNX OCR J (chargé par ONCOCR), les caractères sûrs (confiance ≥ 0,9) enrichissent la bibliothèque, enregistrée aussitôt (remettre O à 0 ensuite). L = chaîne de la vue de contrôle (la trame, où un caractère refusé devient . et un absent _) ; M = 1 un objet par caractère attendu, 2 + contours. Bouton « Voir les gabarits... » de la page : fenêtre des gabarits (vignettes, ressemblance au caractère le plus proche, glyphes jumeaux de la police, dernière exécution sur la trame).
Paramètres
- D
- X1 de la zone
- E
- Y1 de la zone
- G
- X2 de la zone
- H
- Y2 de la zone
- J
- Modèle ONNX OCR (apprentissage)
- K
- Chaîne globale de la trame attendue
- L
- Chaîne globale de la vue de contrôle
- M
- Objets (1 = un par caractère attendu, 2 = + contours)
- N
- Chaîne globale du fichier de gabarits (.ocv)
- O
- 1 = apprentissage par le modèle J
Résultats
- P
- 1 vérification faite, négatif = erreur
- Q
- Score % (caractères attendus retrouvés)
- R
- Caractères attendus
- S
- Caractères retrouvés
- T
- X du 1er caractère (repère pièce)
- U
- Bas du texte trouvé (repère pièce)
- V
- Corrélation moyenne (0..1)
- W
- Cellules en trop
- X
- Pas mesuré (pixels)
- P = 1 vérification faite (même avec un score nul), négatif = échec (bibliothèque absente ou vide, trame vide, zone invalide). Q = score en % des caractères attendus retrouvés : c'est le résultat à comparer à un seuil (80 % sur un marquage jet d'encre validé : aucune bonne ligne refusée, ligne absente, demi-ligne et buses bouchées toujours refusées). R caractères attendus, S retrouvés, T,U bord gauche du 1er caractère et bas de la bande de texte (repère pièce) pour caler la zone de la ligne suivante, V corrélation moyenne, W cellules en trop (heure ajoutée par l'imprimante…), X pas des caractères en pixels.
- Une bibliothèque de gabarits vaut pour une police, une résolution et une caméra. La zone peut déborder sur les lignes voisines : chaque bande de texte est comparée à la trame, la meilleure est retenue.